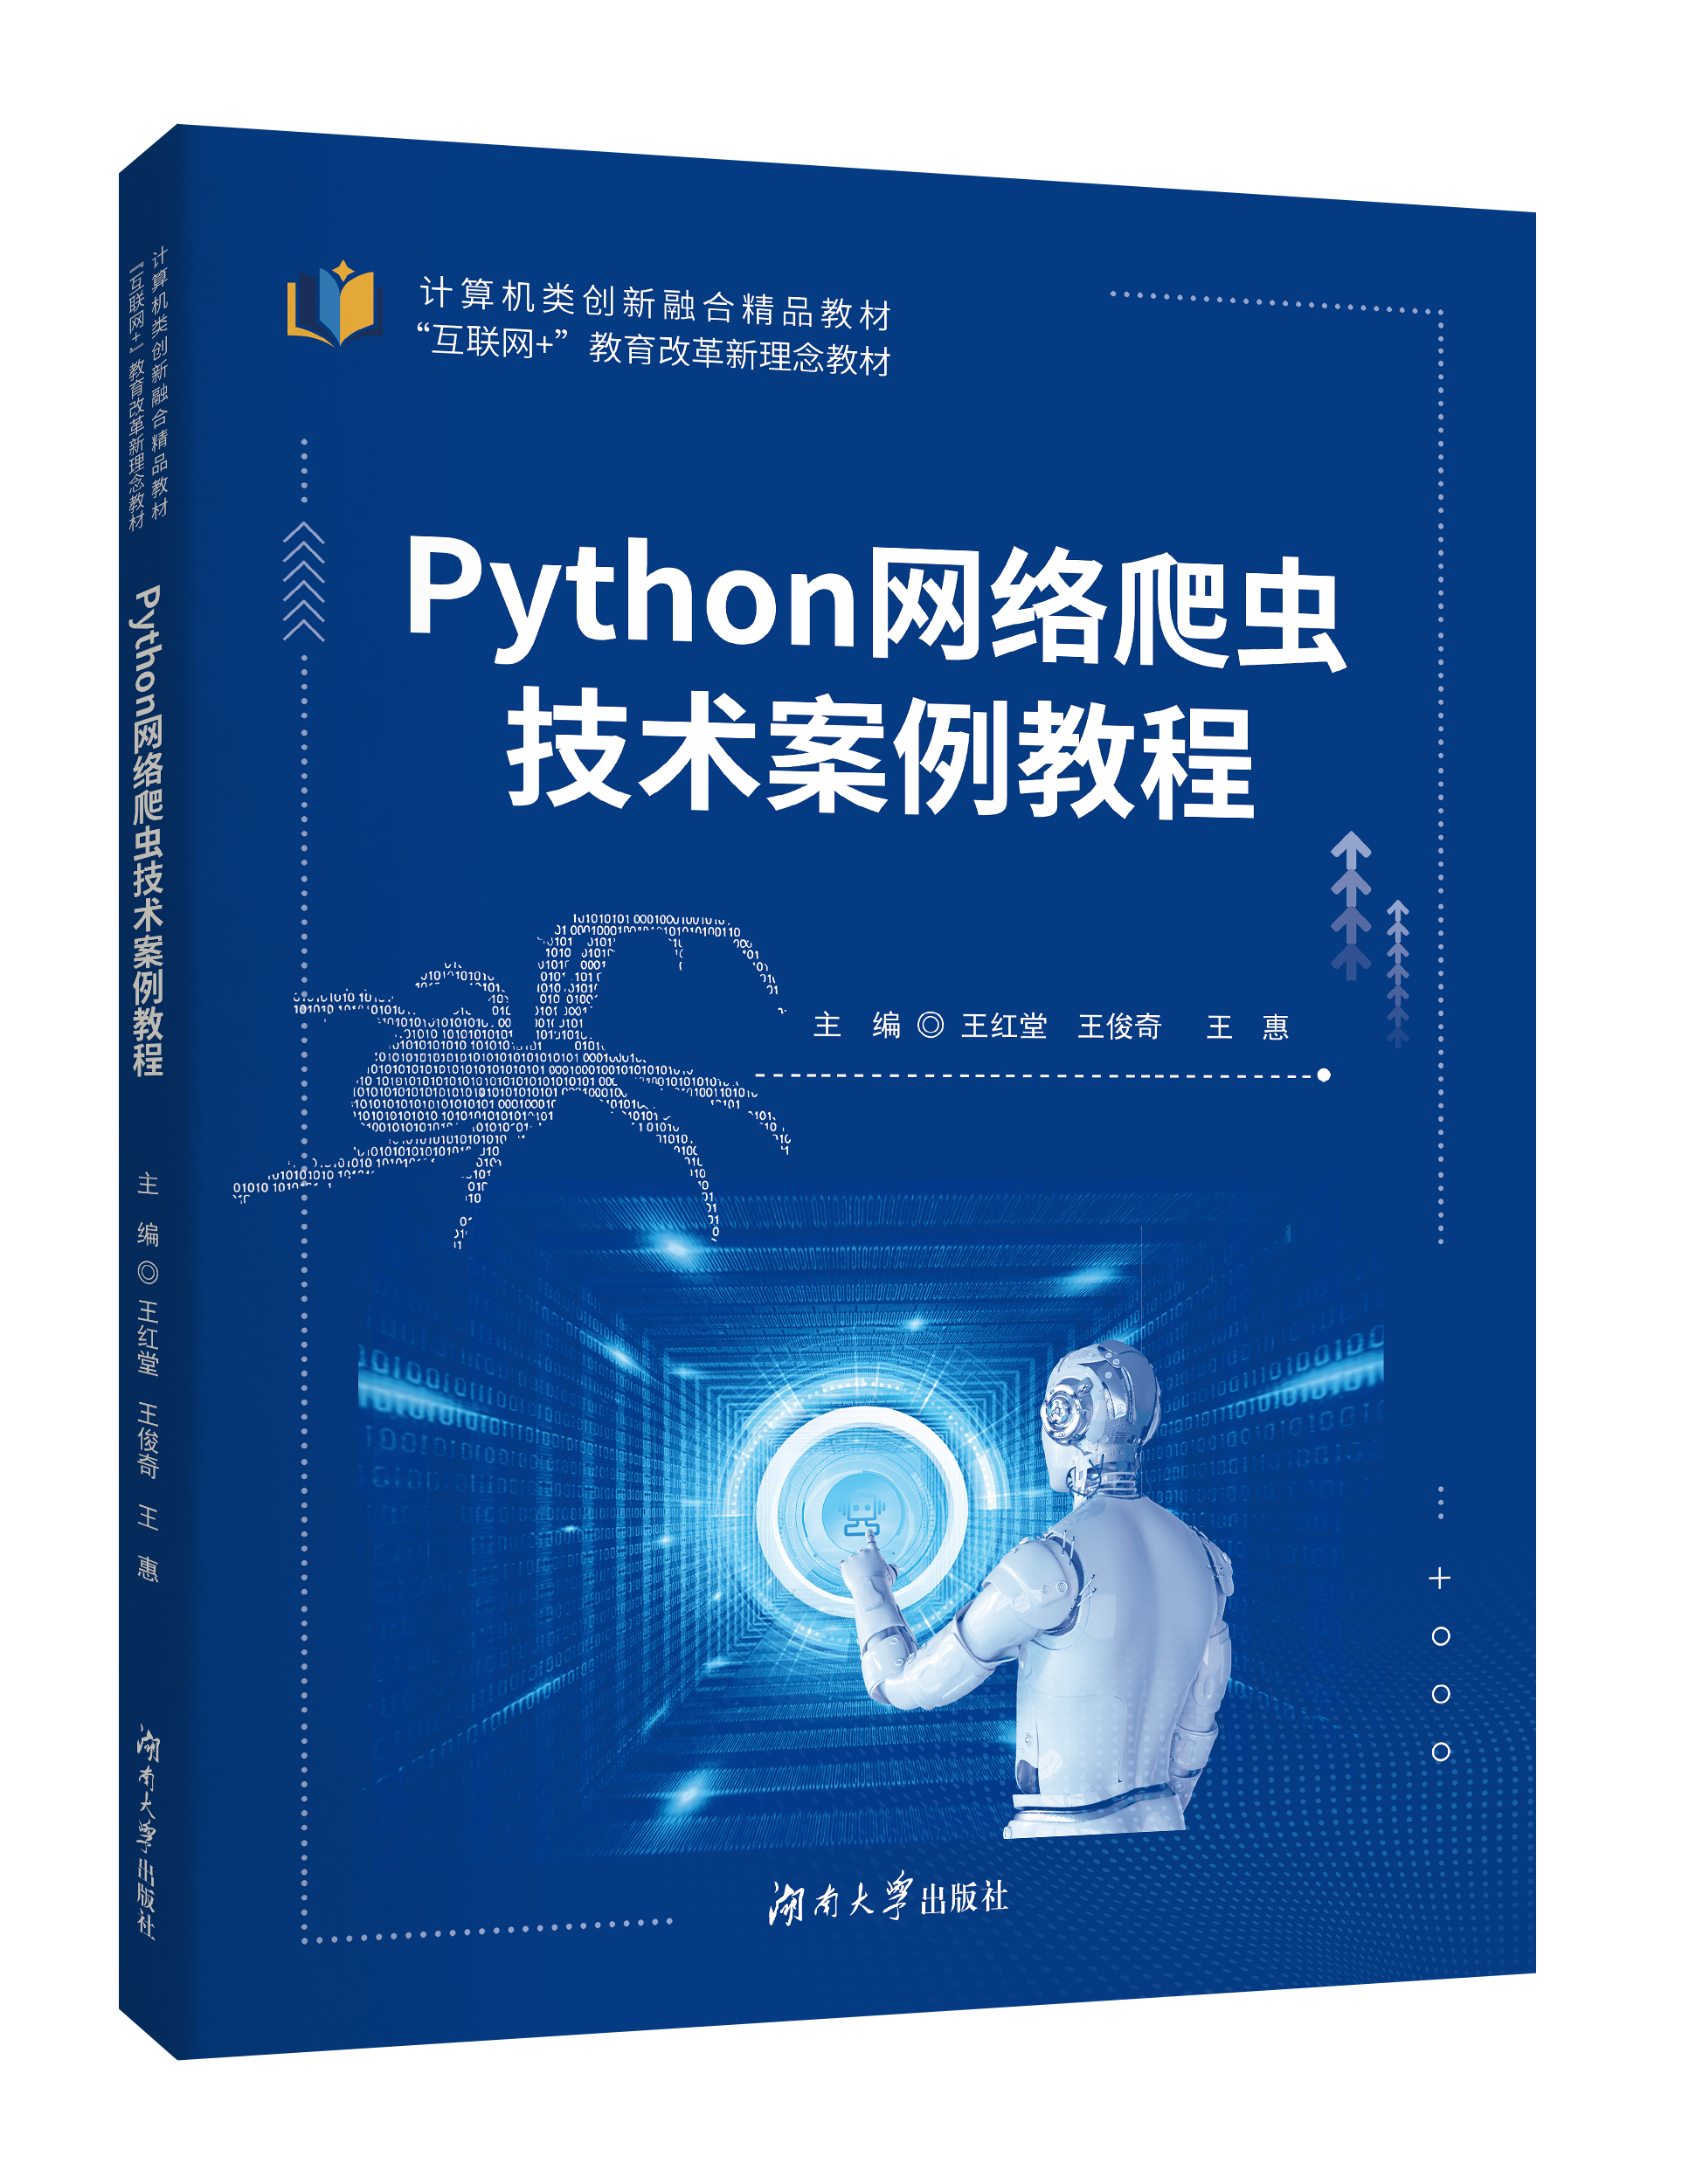
网络爬虫技术的学习之路并非坦途。初学者往往会面临诸多困惑:如何快速掌握爬虫的核心原理与流程?如何规避法律风险,做到合规爬取?如何选择合适的开发工具与技术栈,高效实现数据爬取、解析与存储?如何应对反爬机制,突破爬取瓶颈?如何将爬取的数据转化为可视化成果,发挥数据的实际价值?为解答这些疑问,帮助学习者系统、高效地掌握网络爬虫技术,我们结合多年的实战经验与教学心得编写了本书。
目录:
项目1 网络爬虫技术
任务1.1 揭开面纱:基本概念解析
任务1.2 步步为营:网络爬虫的标准流程
任务1.3 法律边缘:网络爬虫的合法性问题剖析
任务1.4 工具选择:开发语言与开发环境的选择
项目2Web 前端基础
任务 2.1 网络通信:HTTP基本原理详解
任务2.2 网页架构:HTML语言精髓
任务2.3 颜值担当:CSS层叠样式表的奥秘
任务2.4 锦上添花:动态脚本语言的魅力
项目3 Requests 库的使用
任务3.1 从零开始:安装Requests库的正确姿势
任务3.2 精准出击:使用Requests库发送请求的技巧
任务3.3 洞察细节:查看Requests库响应内容的方法
任务3.4 定制专属:定制请求头部Headers的策略
任务3.5 前端调试:夸克浏览器开发者工具面板探秘
项目4 网页解析的核心技术与方法
任务4.1 解析利器:lxml库的高效应用
任务4.2 简单易用:Beautifulsoup4库的解析之道
任务4.3 文本匹配:正则表达式的强大威力
任务4.4 数据留存:存储数据至文件的实用技巧
项目5 IP代理
任务5.1 隐藏身份:IP代理的关键作用解析
任务5.2 得心应手:IP代理的正确使用方法
任务5.3 资源储备:搭建IP池的实用策略
任务5.4 专业之选:付费IP代理的使用指南
项目6 异步爬虫
任务6.1 概念先行:异步爬虫的基本概念与优势
任务6.2 循序渐进:串行下载多个视频的基础实践
任务6.3 并行加速:使用线程池下载多个视频的高效方法
任务6.4 轻量并发:使用协程下载多个视频的进阶技巧
项目7 分布式爬虫技术
任务7.1 分布奥秘:分布式爬虫的原理与优势
任务7.2 强强联合:Scrapy-Redis分布式爬虫的实现
任务7.3 便捷部署:使用Scrapyd部署分布式爬虫的方法
项目8 数据清洗技术
任务8.1 流程把控:数据分析的完整流程概述
任务8.2 去伪存真:数据清洗的概念与详细流程
任务8.3 实用技法:数据清洗的常用方法与技巧
项目9 数据存储
任务9.1 简单存储:文件的存取方法与技巧
任务9.2 轻量存储:SQLite数据库的应用
任务9.3 数据存储:MySQL数据库的管理与使用
项目10 数据可视化
任务10.1 可视利器:Matplotlib的功能与概述
任务10.2 细节把控:图表的常用设置与优化
任务10.3 多样呈现:常用图表的绘制方法与技巧
参考文献
-
查看
 python网络爬虫技术案例教程